
書き終わってから公開まで、やったことのほとんどが確認作業だった
記事10本を書き終えてから公開するまでの記録。ビルドが落ち、日付が埋まらず、番号がズレ、警告が出て、Cloudflareの導線を探し回った。書く時間より確かめる時間のほうが長かった。
書き終わりは、終わりではなかった
前回、サイト立ち上げの記録を書き終えた。そこで終わりのつもりだった。
実際にはそこから公開まで、まだ長かった。しかもやったことのほとんどが、何かを作る作業ではなく、確かめる作業だった。
以下はその記録。順番に詰まったので、順番に書く。
ビルドが落ちた。日本語で書いていた
まず npm run dev が起動しなかった。
[InvalidContentEntryDataError] data does not match collection schema.
  category: Invalid enum value.
    Expected 'tsukuru' | 'sumau' | 'hataraku' | 'kangaeru' | 'neko',
    received 'つくる'
  status: Invalid enum value.
    Expected 'kousou' | 'shisaku' | 'unyou' | 'kuyou',
    received '進行中'
記事のfrontmatterに category: つくる status: 進行中 と日本語で書いていたが、src/content/config.ts のスキーマはローマ字の決め打ちだった。
エラーが正解を全部教えてくれているのが親切だった。期待している値が列挙されているので、そのまま直せばいい。
そしてここで、kuyou(失敗供養)というステータスが実在することに気づいた。自分で設計したはずなのに、忘れていた。ペンディングした時計台や、使わなくなった記事工場に、ちゃんと置き場所が用意されていた。
日付を「XX」のままにしていたら、止められた
もう一つ落ちた。
date: Invalid datefrontmatterの日付を 2026-07-XX のまま放置していた。実際に書いた日を覚えていなかったので、後で埋めるつもりだった。
これに対するClaude Codeの報告が、この一行だった。
XXを含む日付がAstroのz.coerce.date()を通らないことが原因です。実日付を創作できないため、今回は変更していません。
分からないものを、分からないまま止めて報告してきた。もし適当な日付で埋められていたら、たぶん気づかないまま公開していた。
正解は単純で、エクスプローラーでファイルの更新日時を見ればよかった。記憶より正確である。
シリーズ機能を作った
記事が10本になったので、順番に読める形が必要になった。日付順に並べるだけだと、他の記事と混ざる。
frontmatterに2項目を足した。
series: "bibimba-works-log"
seriesOrder: 1
seriesOrder を日付と分けたのには理由がある。SVGアイコンの記事は7月27日に書いたが、内容としては9本目にあたる。書いた日と読ませたい順番は一致しない。
そのうえで、本文中に書いていた「前回(#3)の続き」のような番号参照を全部消した。位置を示すのは記事末尾のシリーズナビと一覧ページの仕事にして、本文からは番号を追い出した。
理由は、直後に実際に起きた。
記事を1本足したら、番号が全部ズレた
シリーズに古い記事を1本追加したところ、その後ろの記事の番号がすべて1つずつ後ろへずれた。本文に「#6に書く」と書いてあった箇所が、全部間違いになった。
番号を本文に持たせると、記事を増やすたびに全記事の修正が必要になる。 これは今回30箇所を書き換えて実感した。
代わりに置いたのが、内容を表すリンクである。
- 「その話は#5に書く」 → 「その話は後の記事に書いた」+リンク
- 「痛い目を見ていた(#5)」 → 「サーバーとメールアドレスの話」+リンク
番号より読みやすいうえに、記事が増えても壊れない。
preview に反映されなくて焦った
誤字を直したのに、npm run preview の表示が変わらない。立ち上げ直しても同じだった。
これは仕様だった。
npm run dev— ソースを直接見ている。保存した瞬間に反映されるnpm run preview—npm run buildで生成されたdist/を配信している。ビルドし直さない限り、古いものを配り続ける
preview は原稿ではなく、印刷済みの束を見ている。同じサイトに見えて、見ている実体が違った。
このあたり、以前に書いたGitの勘違いと同じ構造をしている。画面が同じように見えるとき、裏側で何を見ているかは別の話である。
重複ID警告が出た。調査だけさせた
本番ビルドで、変更した記事に「重複ID」の警告が出るようになった。
ここで、修正させずに調査だけを依頼した。何が起きているか分からないまま直させると、また中身が分からなくなるからである。
返ってきた結論は、別ファイル同士の本当の重複ではなく、キャッシュ判定の偽陽性だった。同じファイルの旧キャッシュと更新後の内容を、Astroのloaderが一時的に重複とみなしていた。警告を出す条件に、ファイルパスが同じかどうかの比較が入っていない、という話だった。
対応は「もう一度ビルドする」だけ。実際、再ビルドで警告は消えた。
何もしないのが正解だった。 そして「何もしないのが正解」と判断できたのは、先に調査させたからである。調査と修正を分けたのは、今回いちばん効いた判断だったと思う。
公開されるものを、総当りで調べた
Cloudflareに接続する前に、安全確認をした。これまで何度か問題が出ていたので、念を入れた。
やり方としては、ソースではなく dist/(実際に公開されるファイル)を対象に総当りで検索させた。公開されないものを調べても意味がないし、公開されるものだけを見れば漏れがない。
調べた項目は以下。
- メールアドレス形式の文字列すべて
- 実名・家族名・電話番号・住所になりうる記述
- Windowsのユーザー名を含むローカルパス
- IPアドレス形式の文字列
- APIキー・トークン・パスワード、
.envの混入 - 会社名・取引先名・業務システム名
- 未処理のプレースホルダ(※要確認、TODO、【 】、HTMLコメントの中身すべて)
- 内部リンク切れと外部リンクの一覧
- 画像の一覧、参照切れ、Exif等のメタデータ
- robots.txt / sitemap / RSS / llms.txt の中身、
draft: trueの記事が生成されていないか
結果は、危険なものはゼロだった。個人メール、実名、実住所、実IP、認証情報、会社名、画像のメタデータ、すべて検出なし。
Exifを確認したのは、写真に位置情報が残っている可能性があったからである。 家で撮った猫の写真がそのまま出ていくので、ここは見ておく必要があった。結果としてWebPにEXIF・XMP・ICCPのいずれも含まれていなかった。
検出されたIPアドレスは、iPhone確認の記事に書いた 192.168.x.x だった。マスク済みのプライベートIPの例なので、そのままにした。
没記事を公開することにした
記事工場の回で「読みやすくて、90点で、そして一度も使わないまま止まった」と書いた草案があった。これを非公開のまま置いておくか、公開するかで迷った。
公開することにした。没だと書いてある記事から現物が読めないのは、片手落ちである。
中身を確認したところ、会社の話も個人情報もプレースホルダも入っていなかった。読み返すと、技術的には正確で結論もちゃんとしている。ただ固有名が全部消えていて、猫が出てくるのは最後の一行だけだった。
没にした理由が、並べて読める状態になった。
llms.txt を書いた
このサイトの差別化は、検索よりもAIに引用されることを想定している。その入口になるのが llms.txt だが、中身が「このファイルは仮内容です」のまま放置されていた。
書き直して、実URLと全記事のリンクを入れた。生成されたものの中で、指示していないのに入っていたのが「AIが引用するときの注意」という節である。
- 記事の数値は執筆者個人の環境での実測であり、一般化された推奨値ではない
- サイト名の表記は「BIBIMBA WORKS」で統一(料理のbibimbapとは綴りが異なる固有名)
- 記事のステータス:構想中 / 試作中 / 運用中 / 失敗供養
- 特色:失敗の記録を成功と同格のコンテンツとして公開
2つ目は、コンセプトを決めた回で書いた「BIBIMBAPは食べ物のほう」がそのまま実装された形になっている。記事に書いた話が、機械可読な形で機能になった。
Cloudflare Pages の入口が見つからなかった
最後の関門がこれだった。
Cloudflareのダッシュボードで「Workers & Pages」→「Create application」と進むと、こういう選択肢が出る。
Continue with GitHub
Connect GitLab
Start with Hello World!
Select a template
Upload your static files
一番上の「Continue with GitHub」を選んだ。これがWorkers のフローだった。
気づいたのは設定画面である。
- 「Configure your Worker project」と書かれている
- Deploy command に
npx wrangler deployが入っている - Build output directory の欄がない(Pagesなら
distを聞かれるはず) - API token を新規作成しようとしている
Advanced settings も開いてみたが、dist を入れる欄はどこにもなかった。このまま進めても、wrangler.toml がないので失敗する。
引き返して、選択画面をもう一度よく見た。Pagesへの導線は、画面の一番下にあった。
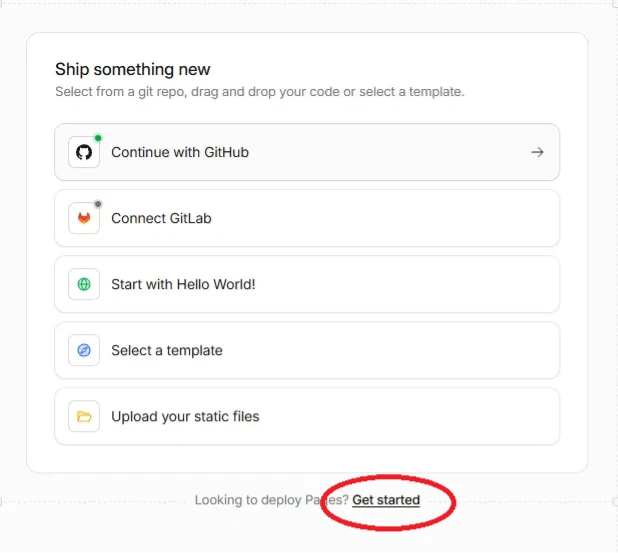
FIG.1 — Pagesへの導線は、選択肢の下にある小さなリンクだった(赤丸は筆者による)。
Looking to deploy Pages? Get started小さい文字のリンクである。ここを押すと「Get started with Pages」の画面になり、ようやく正しいフローに入れた。設定画面に Build output directory: dist の欄があるかどうかが、正しいフローに入れたかの目印になる。
2026年8月時点の話なので、この導線は今後また変わると思う。ただ、Cloudflareが新規プロジェクトをWorkersに寄せているのは確かで、Pagesを使いたい場合は意識して探す必要がある。
接続時の設定
正しいフローに入ってからは、迷うところはなかった。
| 項目 | 設定 |
|---|---|
| Project name | bibimba-works |
| Production branch | main |
| Framework preset | Astro |
| Build command | npm run build |
| Build output directory | dist |
| Root directory | 空欄 |
Project name は後から変更できない。 変える場合はプロジェクトごと作り直しになる。ここは astro.config.mjs の site に書いた値、そして llms.txt に書いた25本のURLと一致させる必要があった。
もう一点、GitHubへの権限を渡すときは Only select repositories を選んで、このリポジトリだけを許可した。全リポジトリへのアクセスを渡す必要はない。
Save and Deploy を押して、数分で公開された。
結局、何をしていたか
書き終えてから公開するまでにやったことを並べると、こうなる。
- スキーマに合わない値を直した
- 日付を実際の更新日時から埋めた
- シリーズ機能を作った
- 本文の番号参照を30箇所リンクに置き換えた
devとpreviewの違いを理解した- 警告を調査して、直さないと判断した
- 公開されるファイルを総当りで安全確認した
- 没記事を公開すると決めた
- llms.txt を実内容に更新した
- 間違ったフローに2回入りかけて、2回引き返した
新しく作ったのは3番だけである。 残りは全部、確かめる作業か、直す作業か、やめる判断だった。
記事を10本書くより、この工程のほうが長かった気がする。実際どうだったかは測っていないので、そう感じた、という以上のことは書けない。
まとめ:確認は減らなかった
以前、AIとサイトを作った結論として「作るはAI、決める・確かめる・止めるは人間」と書いた草案があった。工場が生成した文章で、没にしたものである。
公開までやってみて、この一文だけは当たっていた。
手を動かす仕事は確かに減った。シリーズ機能もリンクの置き換えも安全監査も、自分で実装したわけではない。だが、
- 日付を創作させないこと
- 警告を直させる前に調べさせること
- 公開されるものを総当りで確認させること
- 間違ったフローに入ったと気づいて引き返すこと
これらは減らなかった。むしろ、成果物が速く出てくる分だけ増えた。
そして最後の一つ——間違いに気づいて引き返す——は、たぶん誰にも代わってもらえない。画面には「Deploy」ボタンが出ていて、押せば進む。押さない判断をするところだけが、こちらの仕事だった。
サイトは公開された。ここからは、書いたものが読まれるかどうかの話になる。